
官方网站 · CLI 与 Agent Skill · API / MCP 部署 · 开发指南
yovoice 是一款适用于 macOS 和 Windows 的开源、本地优先(Local-first)声音与音乐创作工作台。
在本地将文字转化为自然逼真的语音、整首带人声歌曲或多轨乐谱。支持零样本音色克隆、情绪风格控制、带歌词人声的 AI 音乐生成、多轨 MIDI 编曲渲染与音频工程管理。完全在本地运行,无云端 API 调用,无按字/按秒扣费开销,无需复杂的 Python 环境配置,让旁白、配音、有声内容与音乐创作更自主、更私密、更低成本。
为什么选择 yovoice?
- 🔒 100% 本地离线与数据隐私:所有模型均在本地显卡/CPU 推理,文本稿件和声音样本永远不会上传到第三方云端。
- 💸 零按字/按秒扣费:无需订阅昂贵的云端 API(告别 ElevenLabs、Suno、商用配音会员计费)。
- ⚡ 原生 C++ 极速引擎,免配 Python:基于 audio.cpp v0.9.1 原生构建,支持 macOS Metal 与 Windows NVIDIA CUDA 12.4/13.3 开箱即用,告别 Conda 与 PyTorch 依赖地狱。
- 🎛️ 全流程专业创作流:多版本试听对比(Takes)、多轨时间轴吸附裁剪、General MIDI 音色库本地渲染与分轨导出(Stems)。
- 🤖 原生 MCP 与 AI Agent 协创:支持接入 DeepSeek、通义千问、Claude、OpenAI 或本地 Ollama 自动写歌写谱,并提供 Model Context Protocol (MCP) 服务,支持在 Cursor 或 Claude Code 中直接调用。
功能
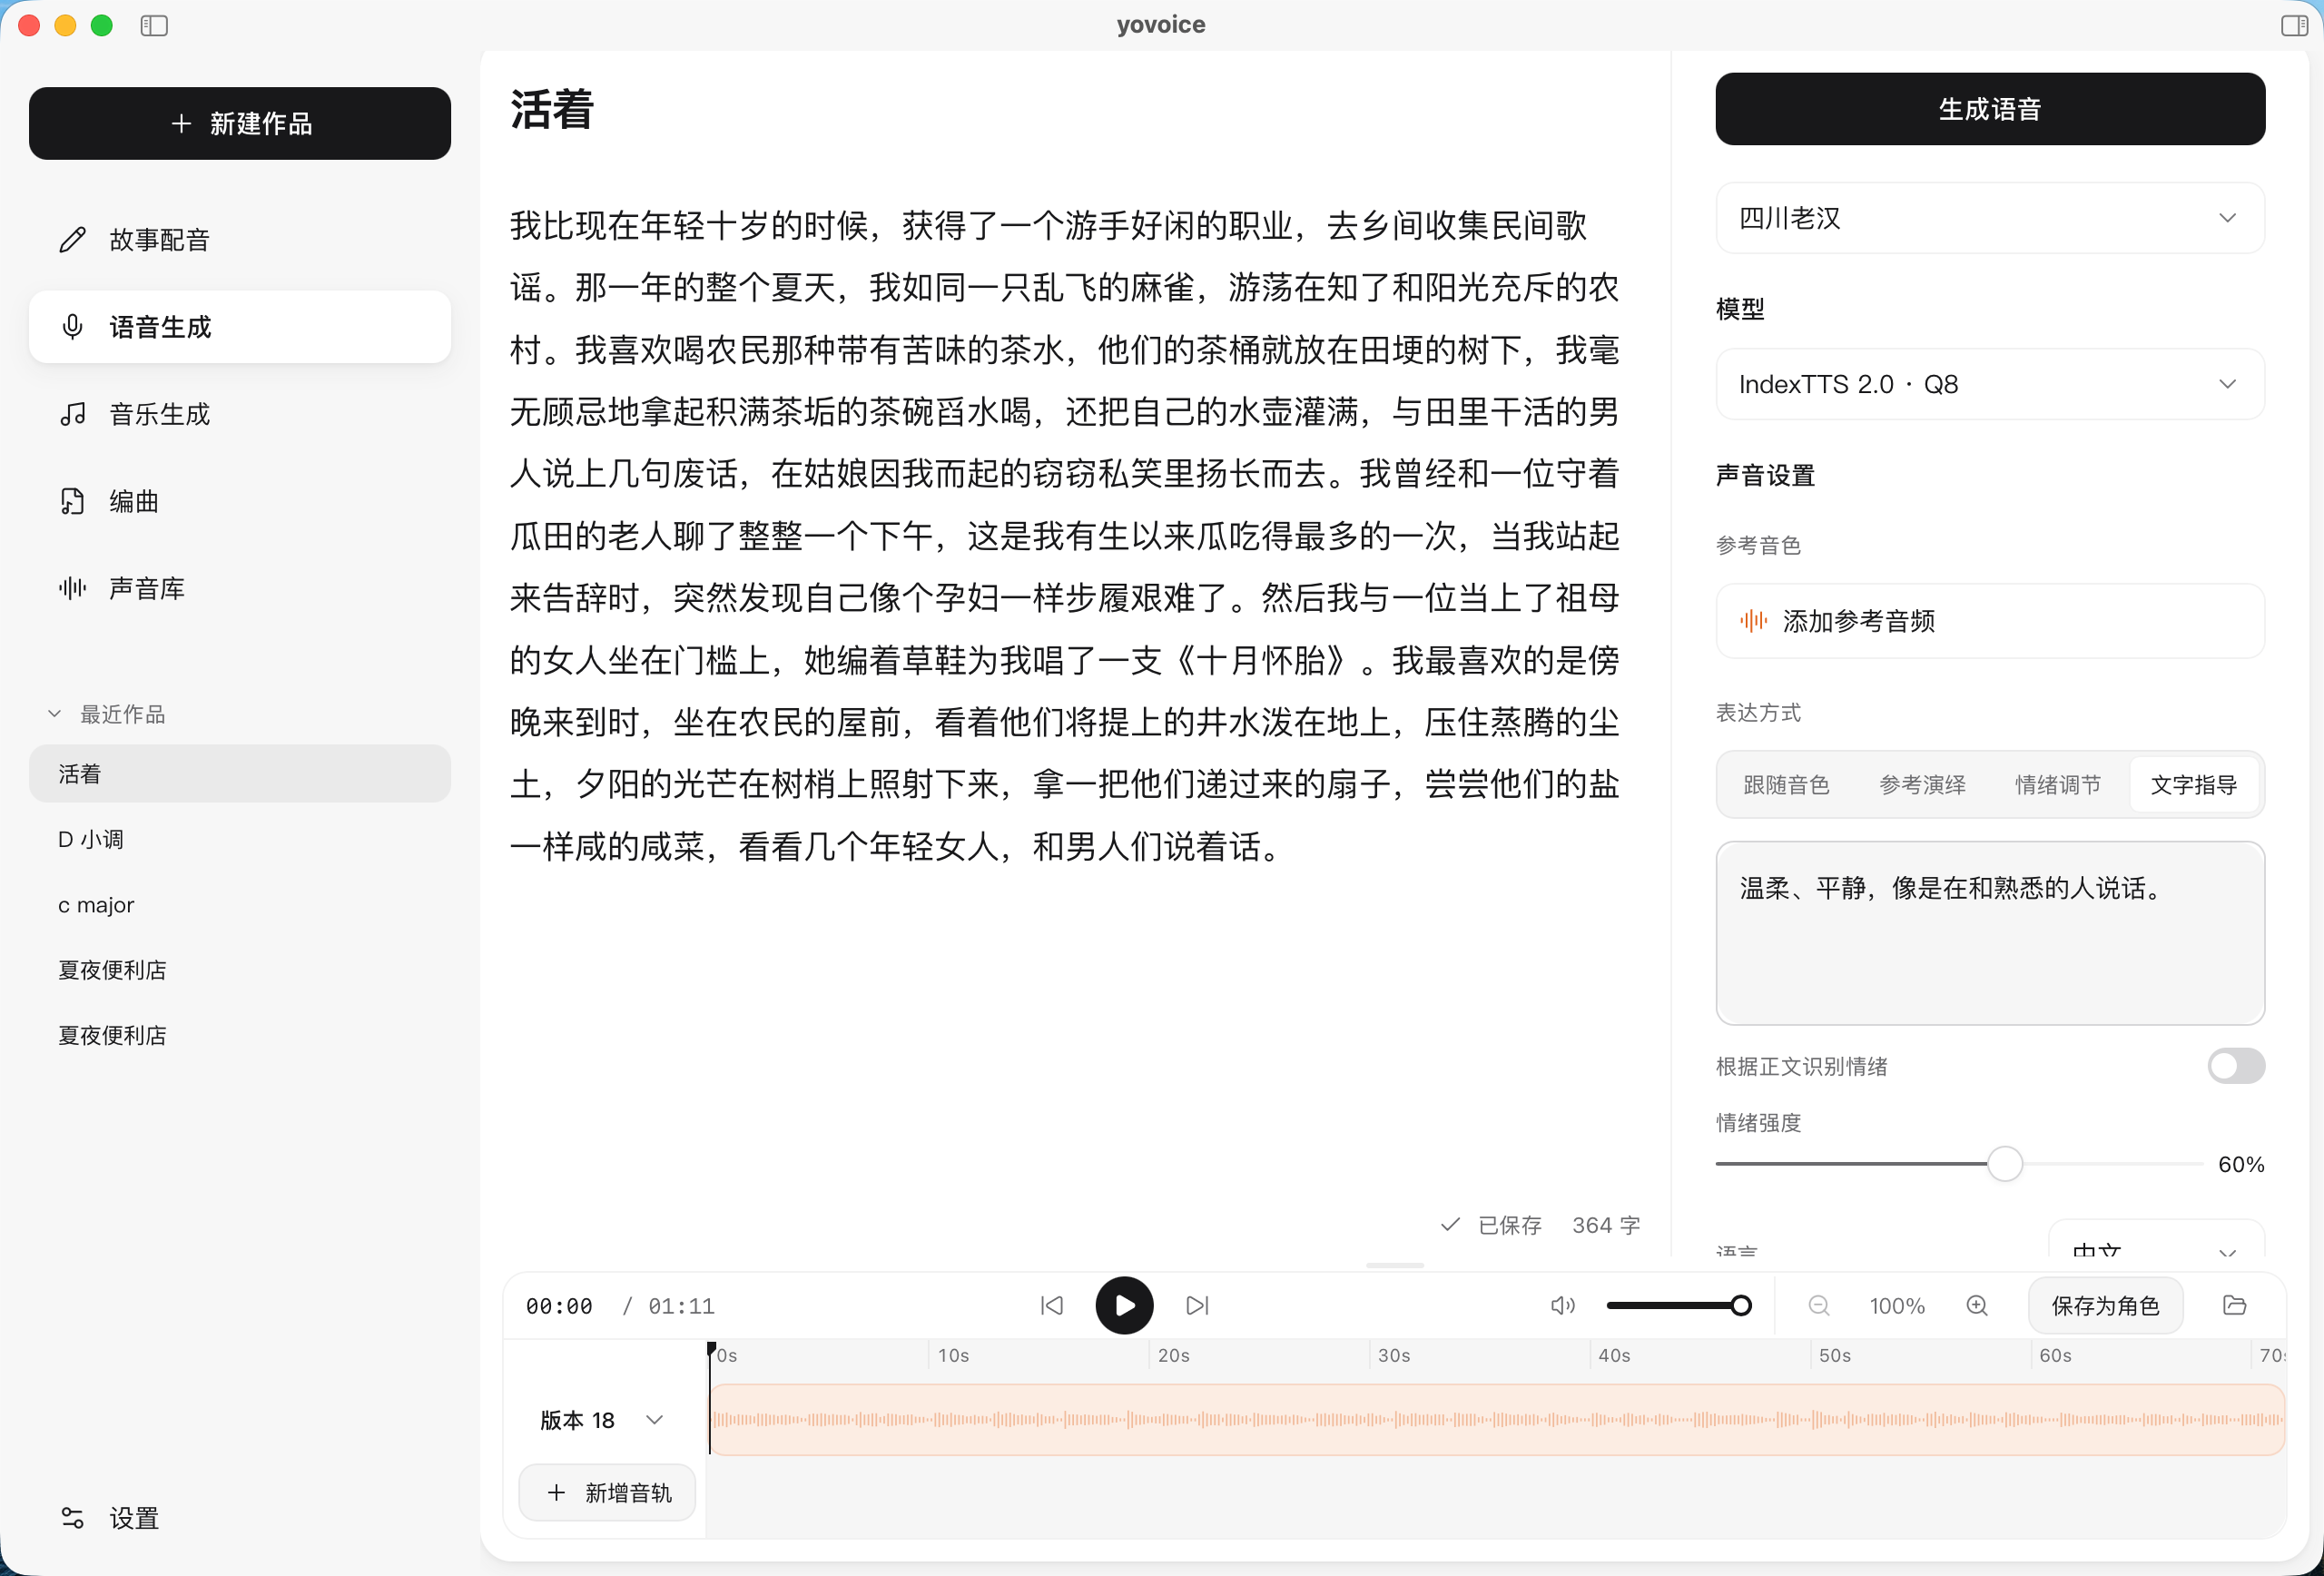
- 语音、声音设计与克隆 — 克隆参考音色、用文字设计声音、调整情绪与演绎,并在音轨上剪辑各个版本。
- 故事配音 — 导入文本或字幕文件,为每句台词分配角色并逐句生成。
- 音乐生成 — 写下风格和带段落标记的歌词,用 ACE-Step 1.5 生成歌曲或纯音乐,或用 YuE2 生成带人声歌曲;播放页按人声同步歌词。
- 编曲 — 按小节和拍写声部,或导入 MIDI、交给 Agent 写谱,用 General MIDI 音色库渲染,导出 MIDI 和分轨。详见编曲。
- 可选 AI 服务 — 让 DeepSeek、通义千问、Kimi、OpenAI、Anthropic、Ollama 或任意兼容接口写谱、写歌词;密钥只保存在本机。详见AI 服务。
支持模型
| 用途 | 模型 |
|---|---|
| 音色克隆与情绪控制 | IndexTTS 2.0 / 2.5、Qwen3-TTS Base |
| 声音设计与克隆 | VoxCPM2、OmniVoice、Qwen3-TTS VoiceDesign、Breeze TTS 2 |
| 内置音色 | Kokoro-82M、Qwen3-TTS CustomVoice |
| 歌曲与纯音乐 | ACE-Step 1.5 Turbo / XL Turbo、YuE2 3B |
所有模型都在 App 内或通过 CLI 下载。文件大小、硬件要求、输入要求与示例见模型选择。OmniVoice、YuE2 和 Breeze TTS 2 的权重仅限非商业用途。
安装
在仓库的 Releases 页面选择对应平台的安装包,或访问官方网站。
| 平台 | 安装包 | 安装方式 |
|---|---|---|
| macOS 14+ · Apple Silicon | .dmg |
打开磁盘映像,将 yovoice 拖入 Applications |
| Windows 10/11 · x64 | -setup.exe |
运行安装向导,安装后从开始菜单打开 |
| Windows 10/11 · x64 · NVIDIA 显卡 | -cuda12.4-setup.exe |
内置 CUDA 12.4 内核,兼容较旧的显卡与驱动,首次启动即用 GPU |
| Windows 10/11 · x64 · NVIDIA 显卡 | -cuda13.3-setup.exe |
内置 CUDA 13.3 内核,需要较新的驱动,安装包更小 |
Windows 安装器会在缺少时联网安装 WebView2 Runtime。模型在应用内下载。卸载应用保留 ~/.yovoice 中的作品和模型。
macOS 和 Windows 均支持在应用菜单中检查更新,也会自动检查并后台下载;下载完成后可选择重启安装。Windows 自动更新只下载应用本体(-update.exe),保留已安装的内核;新版本推荐更高的内核时,可在 设置 → 推理引擎 中选择升级。
快速上手
- 准备模型。 在设置中下载所需模型(例如轻量朗读用 Kokoro-82M,声音克隆用 VoxCPM2)。
- 新建作品。 选择“故事配音”、“语音生成”、“音乐生成”或“编曲”。
- 填写内容。 输入文字、歌词或音符,选择角色并调整风格。
- 生成音频。 点击“生成”,试听对比多版本(Takes)、编辑并导出。
CLI 与 Agent Skill
将 yovoice Skill 链接发给 Agent,让它安装 Skill,并准备本地 CLI、引擎和模型:
安装这个 Skill,并帮我配置好 yovoice 本地语音生成环境:https://github.com/leemysw/yovoice/tree/main/skills/yovoice
之后直接描述需求:
用 voice.wav 的音色朗读 narration.txt,语气平静,保存为 narration.wav。
Agent 通过独立 CLI 完成配音,无需打开桌面应用。详细用法见 CLI 指南。
运行 yovoice serve 可为其他机器提供带认证的 HTTP API 与 MCP 推理服务,支持上传参考音频与生成 WAV。部署和调用示例见API / MCP 部署指南。
开发
make install
make app-run
环境要求见开发指南,其中也介绍了浏览器预览、测试和项目结构。
交流群
使用微信扫码加入 yovoice 用户交流群。二维码过期时,欢迎提交 Issue,我们会及时更新。
参与贡献
欢迎提交问题、功能建议和 Pull Request。报告问题时,请附上操作系统、模型及复现步骤;提交代码前运行 make check。
鸣谢
- audio.cpp — ShugoAI 开发的本地音频推理引擎。
- VoxCPM — 声音设计与克隆模型,Apache-2.0 许可。
- IndexTTS — 为 yovoice 提供语音合成模型。
- OmniVoice — 声音设计与音色克隆模型。
- Qwen3-TTS — 支持音色克隆、内置音色与文字设计声音。
- ACE-Step — 根据风格描述与歌词生成音乐。
- YuE — 根据歌词生成整首带人声歌曲。
- Breeze TTS 2 — 中英文声音设计与音色克隆。
- go-meltysynth、MuseScore General、GeneralUser GS 与 David Shan 的 SGM-V2.01 — 编曲渲染使用的 SoundFont 合成器与音色库。
- Kokoro — 使用内置音色的轻量语音合成模型:Kokoro-82M 与 Kokoro-82M-v1.1-zh。
数据统计
数据评估
关于yovoice — 本地 AI 配音、声音克隆与文字转语音特别声明
本站莉可POI提供的yovoice — 本地 AI 配音、声音克隆与文字转语音都来源于网络,不保证外部链接的准确性和完整性,同时,对于该外部链接的指向,不由莉可POI实际控制,在2026年10月17日 17:43收录时,该网页上的内容,都属于合规合法,后期网页的内容如出现违规,可以直接联系网站管理员进行删除,莉可POI不承担任何责任。
相关导航
没有相关内容!

暂无评论...